Cairn
留下一段声音,隔些日子再听。
留下一段当下,也能够在以后回来看看,并分清原话与生成的回应。
- 48
- 次提交,三周
- 2
- 端:iPhone 与 Apple Watch
- On-device
- 正式版的 AI、识别与朗读
- 17k
- 行 Swift
截至 2026-09-08,来自代码仓库与发版记录
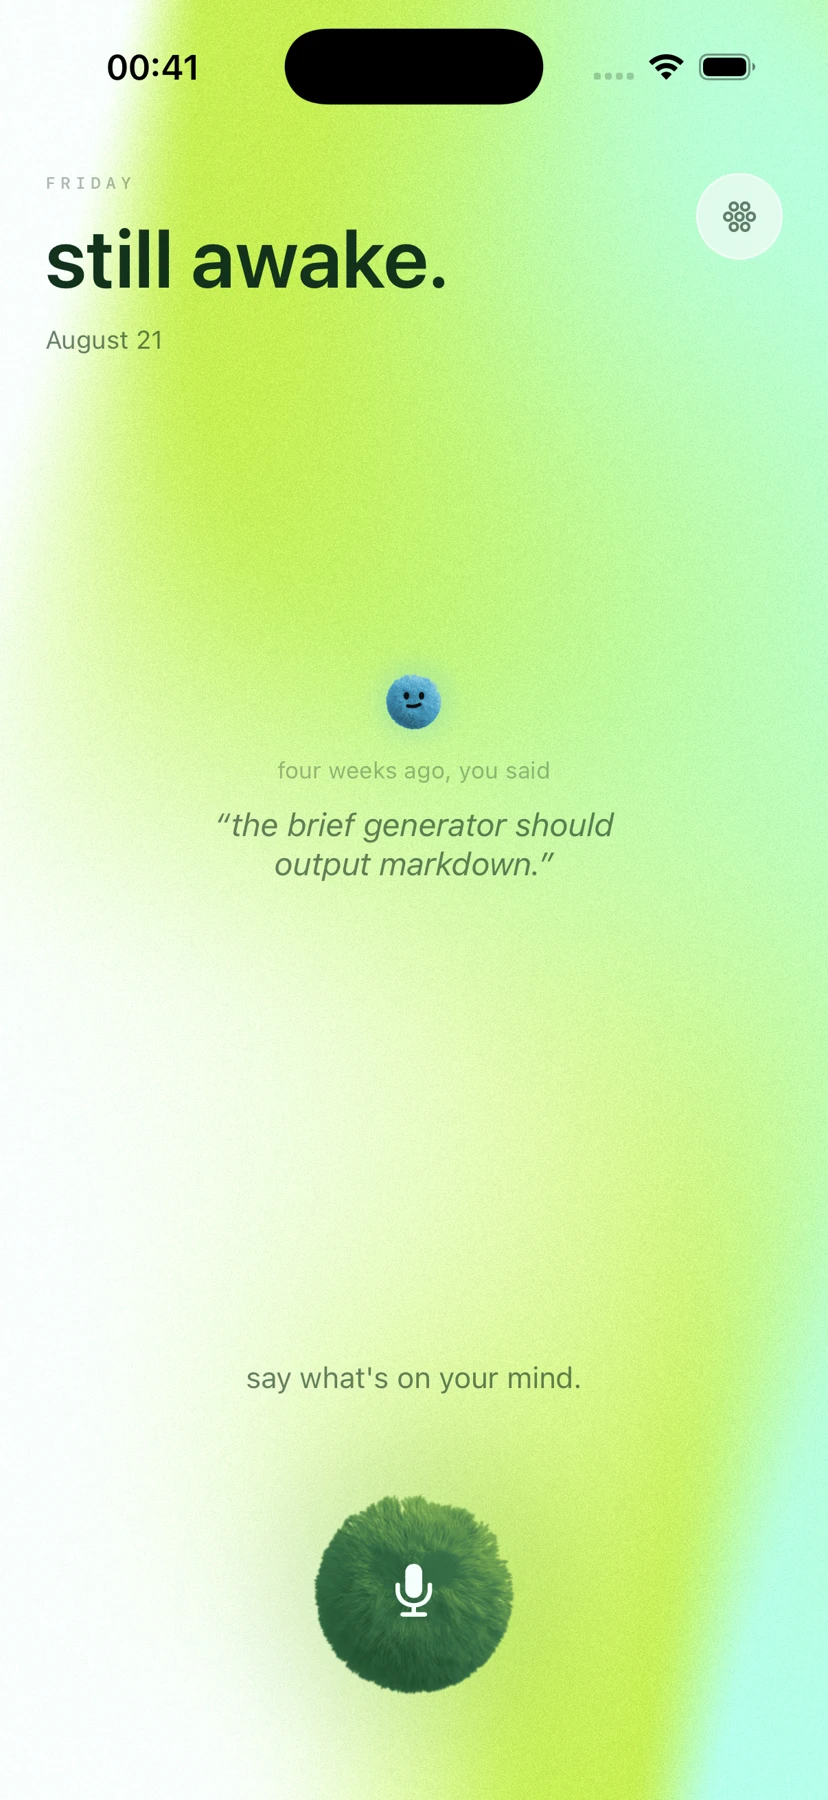
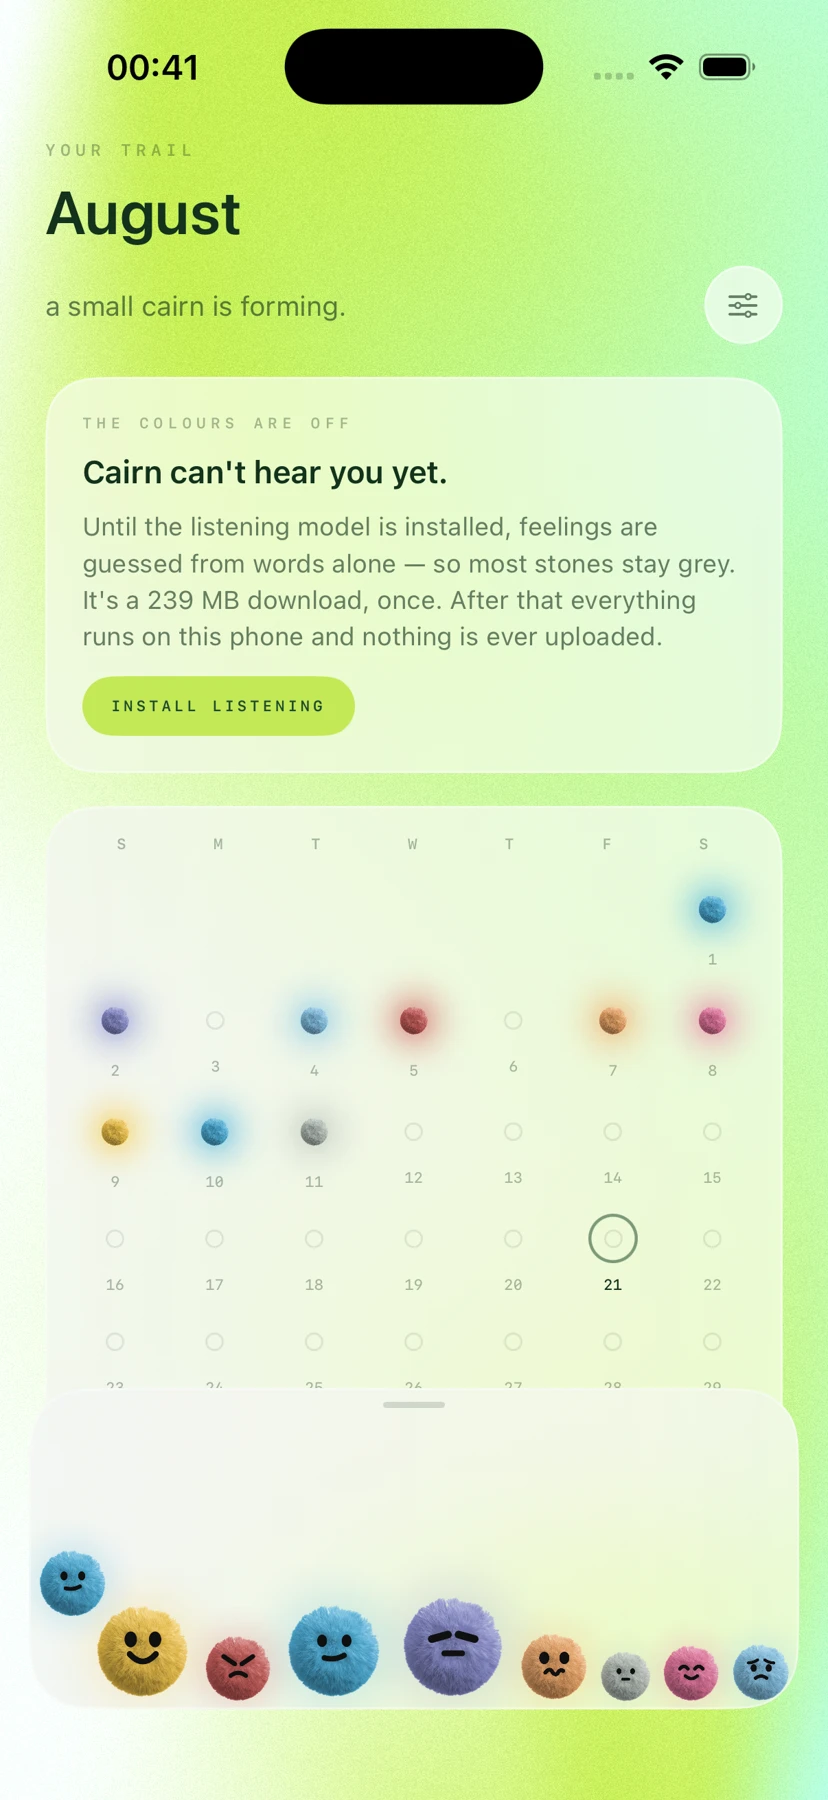
来自真实开发版本的画面
它怎么运作
- 01
留下录音
在一次对话里留下文字或语音,并明确记录说话者。
- 02
保存片段
保存这一刻以及相关的对话记录。
- 03
再次回访
围绕选中的时刻寻找上下文,再与过去的自己对话。
- 04
展开对话
生成的文字与原始记录保持区分,不冒充当年的原话。
难在哪,怎么解决的
留下当下,给未来一次回看的机会。
一段录音承载的是当时自己的表达。后来的回应可以帮助回看,但原话需要保留自己的位置。
不上云也能回应的日记
- 难在哪
- 语音日记里是一个人说过最私密的话。为了得到回应把它传到服务器上,就失去了意义。
- 我怎么做
- 正式版里,语音识别、回应的生成和朗读都在设备上用 Apple 自己的框架完成;远程模型只作为测试者手动开启的选项存在。
- 结果
- 原生依赖按固定版本下载并校验哈希。
留住原话,而不只是总结
- 难在哪
- AI 总结会把一个人说话的方式抹平,而那往往才是日后最值得回看的部分。
- 我怎么做
- 原始录音和原话都被保留。每一次回应都锚定在某个过去的时刻上,随时可以和当时的原话对照。
- 结果
- 文档里写明了尚未证明的事:不做任何临床或长期效果的声称。
独立项目独立语音记忆项目,原始录音与生成反思分别呈现。
技术栈
SwiftUI · ObservationSwiftDataAVFoundation · SpeechFoundationModels可选的远端大语言模型时间范围内的回忆检索Keychain 配置存储
实现细节
生成反思是新的回复,不是恢复出的过去原话或过去声音。
- 你的录音
- 保留并区分用户原本的表达。
- 记忆空间
- 在录下的片段与对话之间切换。
- 对话会话
- 协调用户与生成内容,明确各自的来源。
- 过去情境
- 用选定的时间视角限定生成回复的情境。
- 本地记忆
- 保存录音元数据及对应音频文件。
- 模型路线
- 使用受支持的设备端模型或明确配置的远程路线。